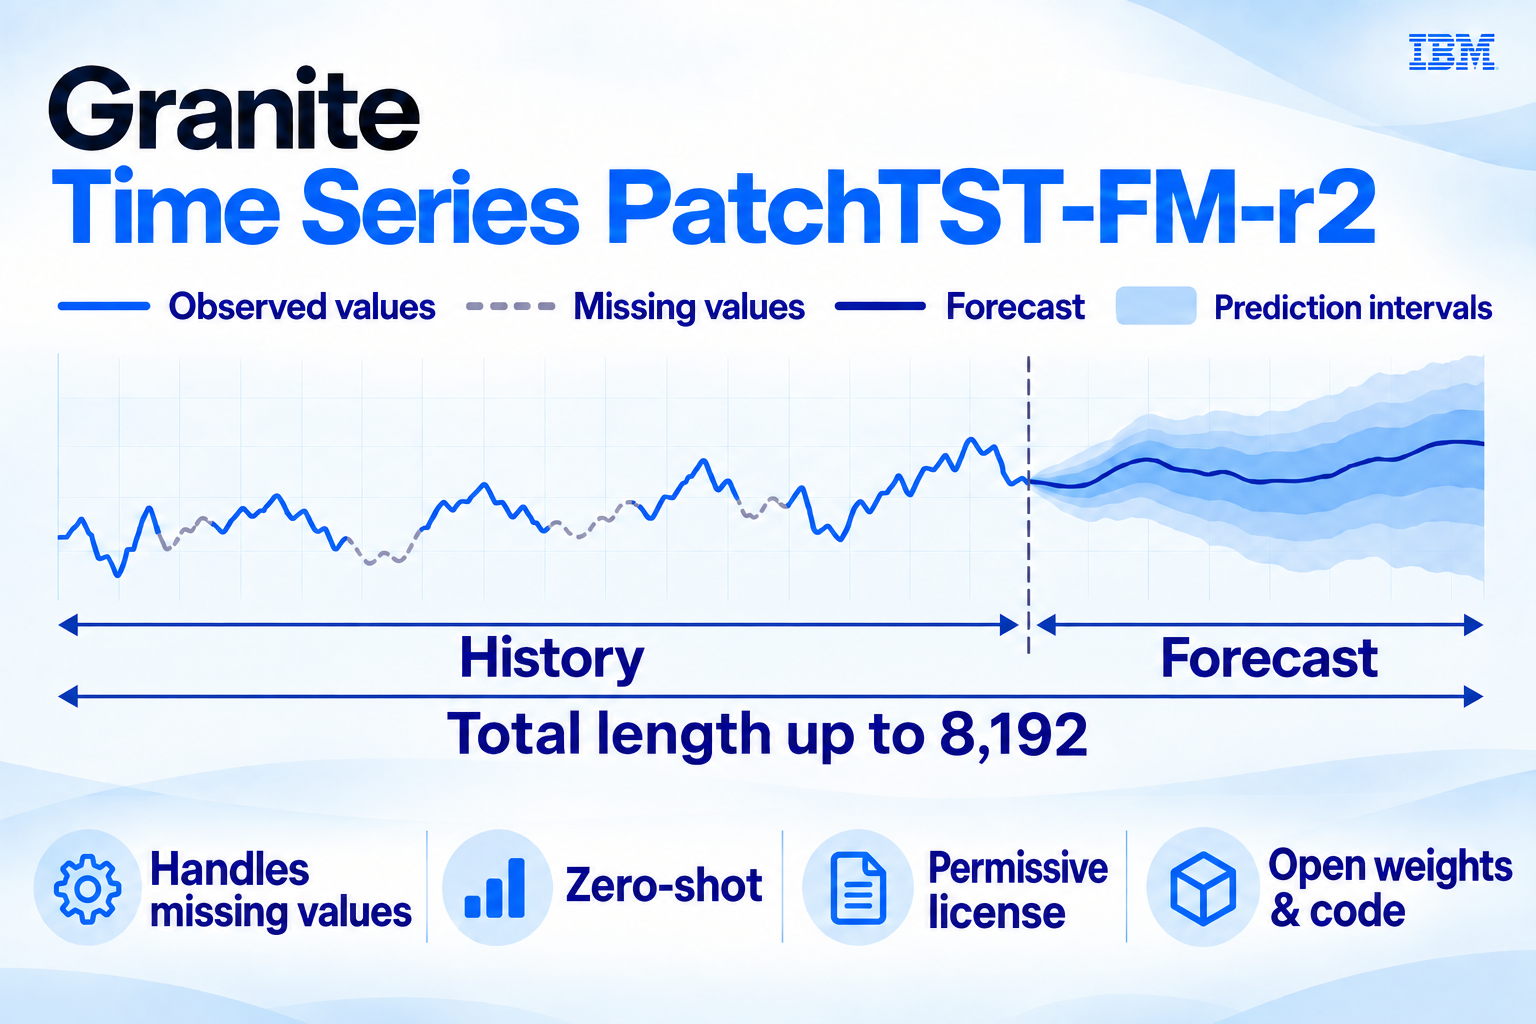
상업 친화적 라이선스와 함께 SOTA Granite Time Series PatchTST-FM-r2 모델 출시
이 글은 Hugging Face 블로그의 IBM releases SOTA Granite Time Series PatchTST-FM-r2 model with commercial-friendly license를 한국어로 번역한 글입니다.
상업 친화적인 오픈 라이선스를 제공하는 고성능 제로샷 예측
시계열 파운데이션 모델은 예측 시스템을 구축하는 방식을 바꾸고 있습니다. 각 데이터셋마다 별도의 모델을 학습하고 유지 관리하는 대신, 사용자는 사전 학습된 모델을 사용해 제로샷 방식으로 예측을 생성할 수 있습니다.
IBM은 Granite TSFM 제품군의 최신 모델인 Granite Time Series PatchTST-FM-r2(GitHub, 블로그)를 출시했습니다. 이전 버전인 PatchTST-FM-r1의 새로운 버전인 PatchTST-FM-r2는 업데이트된 아키텍처, 더 큰 사전 학습 코퍼스, 확률적 예측, 결측값 대치 지원, 그리고 약 385M개 파라미터 모델에서의 강력한 제로샷 성능을 결합합니다.
2026년 9월 8일 기준으로 이 모델은 GIFT-Eval 리더보드의 재현 가능한 제로샷 모델 가운데, 관대한 상업 친화적 오픈 소스 라이선스(Apache 2.0 및 OpenMDW 1.0)로 출시된 모델 중 가장 높은 성능을 보이는 제로샷 모델입니다. GIFT-Eval은 다양한 예측 시나리오에서 모델을 평가하도록 설계된 종합 시계열 예측 벤치마크이며, 이 모델은 재현 가능한 제로샷 모델 가운데 전체 2위를 차지합니다.
벤치마크 결과를 재현하는 데 필요한 모델 가중치, 아키텍처, 추론 파이프라인, 코드가 모두 제공됩니다.
이 블로그에서는 모델을 설명하고, 벤치마크 결과와 모델 아키텍처를 자세히 살펴보며, 학습 데이터와 라이선스를 논의하고, 모델 사용 방법을 보여 주는 코드 예제를 제공합니다. 마지막으로 Confluent 제품를 활용해 Granite Time Series 제품군의 모델을 프로덕션 환경의 스트리밍 애플리케이션에서 사용하는 방법도 소개합니다.
직접 사용해 볼 준비가 되셨나요? Hugging Face에서 Granite Time Series PatchTST-FM-r2 열기
TL;DR
-
수요, 가격, 에너지 부하, 트래픽, 텔레메트리 및 기타 시계열을 위한 범용 제로샷 예측.
-
약 385M개 파라미터, 최대 8,192의 문맥 길이, 유연한 예측 길이, 99개 분위수 예측 헤드를 통한 확률적 예측.
-
모델 백본은 멀티 헤드 자기 어텐션과 시간축 합성곱을 결합하는 Conformer 블록으로 구성되어 장기 및 단기 시간적 구조를 포착합니다.
-
GIFT-Eval 벤치마크의 재현 가능한 제로샷 범주에서 최고의 성능을 보이는 관대한 라이선스 모델(Apache-2.0 및 OpenMDW-1.0 이중 라이선스이며, 사용자는 두 라이선스 중 하나를 선택할 수 있음).
-
벤치마크를 재현하는 데 필요한 오픈 가중치, 아키텍처, 추론 파이프라인 및 코드 제공.
GIFT-Eval에서 강력한 제로샷 예측
파운데이션 모델은 특별히 학습되지 않은 시계열에도 일반화할 때 가장 유용합니다. 이러한 이유로 먼저 제로샷 성능에 초점을 맞춥니다.
GIFT-Eval은 서로 다른 데이터셋과 예측 시나리오에 걸쳐 예측 모델을 폭넓게 평가합니다. 리더보드를 제로샷이고 재현 가능하며 테스트 누수 없이 평가된 모델로 제한하면, 2026년 9월 8일 기준 PatchTST-FM-r2는 그림 1 및 2에 나와 있듯 CRPS와 MASE 모두에서 2위를 차지합니다(두 지표 모두 값이 낮을수록 더 좋습니다). 중요한 점은, 동일한 범주에서 관대하고 상업 친화적인 라이선스를 보유한 모델 가운데 PatchTST-FM-r2가 가장 높은 성능을 보이는 모델이라는 것입니다.

그림 1. 주요 재현 가능 제로샷 모델의 GIFT-Eval CRPS. PatchTST-FM-r2는 기하평균 CRPS 0.467을 달성해 이 비교에서 TimesFM-3 바로 다음 순위에 올랐으며, 관대한 라이선스를 보유한 모델 가운데 1위를 차지했습니다.

그림 2. 주요 재현 가능 제로샷 모델의 GIFT-Eval MASE. PatchTST-FM-r2는 기하평균 MASE 0.6846을 달성했습니다. 파란색 막대는 IBM 시계열 파운데이션 모델 팀이 출시한 모델을 나타냅니다.
벤치마크 학습 데이터를 사용할 수 있는 모델과 비교해도 경쟁력 있는 성능
GIFT-Eval의 일부 모델은 엄격한 제로샷이 아닌 사전 학습 모델로 분류됩니다. 이러한 모델은 GIFT-Eval 평가 데이터셋의 학습 부분을 사전 학습 코퍼스에 포함할 수 있습니다.
이러한 사전 학습 모델을 비교에 추가하더라도 PatchTST-FM-r2는 그림 3 및 4에서 볼 수 있듯 상위권을 유지합니다. 재현 가능한 모델 가운데 CRPS에서는 3위, MASE에서는 4위입니다. 일부 경쟁 모델이 상당히 더 큰 규모임에도 Chronos-2, Timer-S1, Toto 변형 모델을 포함한 여러 사전 학습 모델보다 우수한 성능을 보입니다.

그림 3. 제로샷 모델과 사전 학습 재현 가능 모델을 모두 고려한 GIFT-Eval CRPS.

그림 4. 제로샷 모델과 사전 학습 재현 가능 모델을 모두 고려한 GIFT-Eval MASE.
아키텍처: PatchTST-FM-r1에서 무엇이 바뀌었나?
PatchTST-FM-r2는 PatchTST 제품군의 효과를 뒷받침한 패치 기반 표현을 유지하지만, 장기 및 단기 관계를 효율적으로 포착하고 패치 간 예측을 평활화하도록 내부 아키텍처를 재설계했습니다. 이 두 가지 변화는 모두 오류 지표를 크게 개선합니다.
한 가지 변화는 표준 트랜스포머 레이어에서 멀티 헤드 자기 어텐션과 함께 합성곱을 통합하는 레이어로 전환한 것입니다. 이러한 레이어를 Conformer 레이어라고 하며, 음성 처리 애플리케이션에서 유래했습니다.

그림 5. PatchTST-FM-r1에서 Conformer 기반 PatchTST-FM-r2로의 아키텍처 진화.
PatchTST-FM-r1 블록은 멀티 헤드 자기 어텐션과 피드포워드 신경망을 결합합니다. r2에서는 이를 Conformer 스타일 블록으로 교체했으며, 이 블록은 멀티 헤드 자기 어텐션과 시간축 합성곱 레이어를 출력을 절반으로 줄이는 피드포워드 레이어 두 개가 둘러싸는 구조입니다.
이를 통해 모델은 시계열을 추론하는 두 가지 상호 보완적인 메커니즘을 갖게 됩니다. 자기 어텐션은 패치 간 장거리 관계를 모델링할 수 있고, 합성곱은 국소적인 시간적 구조에 대한 귀납적 편향을 제공합니다. 따라서 합성곱 구성 요소는 단기 상호작용을 포착하는 동시에 어텐션이 더 긴 시간 범위의 관계에 집중하도록 할 수 있습니다. 이 현상은 트랜스포머 및 Conformer 버전에서 포착된 어텐션 패턴에서 확인할 수 있습니다(아래 예시 그림은 ETTh1 데이터셋의 실제 표본을 사용함). 트랜스포머의 자기 어텐션 상당 부분(그림 왼쪽)은 대각선 부근에 집중되어 국소적인 관계를 포착하는 반면, Conformer 블록의 어텐션(그림 오른쪽)은 합성곱 레이어가 짧은 거리를 담당하기 때문에 장거리(대각선에서 먼 위치)에 집중하는 모습을 보입니다. 백본의 Conformer 블록은 3과 5의 합성곱 커널 크기를 {5, 5, 3, 3} 패턴으로 반복해 교차 사용합니다.

그림 6. ETTh1 데이터셋의 실제 표본을 사용해 트랜스포머(왼쪽)와 Conformer 버전(오른쪽)에서 포착된 어텐션 패턴 비교.
또한 PatchTST-FM-r2는 해밍 윈도 가중치를 적용한 50% 겹치는 패치와 중첩 가산(overlap-and-add) 예측을 사용해 패치 경계를 평활화하고 예측 정확도를 향상합니다. 마지막으로 안정성을 위해 정규화를 추가하고 블록 수를 20개에서 30개로 늘렸습니다.
이러한 변경을 통해 완성된 모델은 약 385M개 파라미터를 가지며, 최대 8,192 시점의 매우 긴 문맥을 지원하고, 유연한 예측 길이에 대해 99개 분위수를 예측합니다. 이 모델은 예측 분포와 불확실성 구간을 위한 점 예측과 분위수 출력을 모두 제공합니다.
학습 데이터
실제 애플리케이션을 대상으로 하는 파운데이션 모델에서는 모델 품질이 고려 사항의 전부가 아닙니다. 개발자는 모델에 어떤 데이터가 사용되었는지, 벤치마크 데이터가 학습에 유출되었을 가능성이 있는지, 모델 배포에 어떤 영향이 있는지를 점점 더 잘 이해해야 합니다.
PatchTST-FM-r2는 네 가지 소스로 구성된 문서화된 사전 학습 코퍼스를 사용합니다. 네 가지 소스는 GiftEvalPretrain에서 선택한 데이터셋, 수정된 주기적 커널과 제한적인 데이터 증강을 적용한 KernelSynth 기반 맞춤형 합성 데이터, Chronos가 설명한 접근 방식으로 생성했지만 GIFT-Eval 평가 세트 외부의 데이터셋으로 제한한 TSMixup 코퍼스, 그리고 각각 길이 4,096인 약 500,000개의 합성 CauKer 시퀀스입니다.
기업 도입자에게 이러한 투명성은 리더보드에서 몇 점을 더 얻는 것만큼 중요할 수 있습니다. 이것이 조직 자체의 모델 거버넌스 및 라이선스 검토 필요성을 없애지는 않지만, 불투명한 사전 학습 코퍼스보다 훨씬 더 많은 정보를 제공하므로 사용자가 해당 검토를 수행하는 데 도움이 됩니다.
연구 실험 및 상업적 사용을 위해 공개
커뮤니티에 더 많은 선택권을 제공하기 위해 Granite Time Series PatchTST-FM-r2는 Apache 2.0 및 OpenMDW 1.0의 이중 라이선스로 제공됩니다. 사용자는 두 라이선스 중 하나를 선택할 수 있으며, 두 라이선스 모두 모델을 사용, 수정 및 배포할 수 있는 폭넓고 관대한 권리를 제공합니다. 또한 Linux Foundation의 OpenMDW는 AI 모델과 관련 자료를 위해 특별히 설계된 라이선스 프레임워크를 제공합니다. IBM은 관대한 오픈 소스 라이선스로 모델을 제공함으로써 도입 장벽을 낮추고, 사용을 제한하지 않는 라이선스가 제공하는 확신을 바탕으로 조직, 연구자 및 개발자가 이 기술을 구축해 나갈 수 있도록 하는 것을 목표로 합니다. 아키텍처 구현은 Granite-TSFM 저장소를 통해서도 제공되며 PatchTST-FM-r1 체크포인트와 하위 호환합니다.
몇 줄의 Python 코드로 PatchTST-FM-r2 사용해 보기
파운데이션 모델을 평가하는 가장 쉬운 방법은 자체 시계열 데이터에 적용해 보는 것입니다.
Granite TSFM 패키지를 설치합니다:
pip install "granite-tsfm>=0.3.9"
그런 다음 Hugging Face Hub에서 PatchTST-FM-r2를 직접 불러옵니다:
import pandas as pd
from tsfm_public import PatchTSTFMForPrediction, TimeSeriesForecastingPipeline

# Load model weights
model = PatchTSTFMForPrediction.from_pretrained(
    "ibm-granite/granite-timeseries-patchtst-fm-r2"
)

# Read some sample data from ETTh
df = pd.read_csv(
    "https://raw.githubusercontent.com/zhouhaoyi/ETDataset/main/ETT-small/ETTh1.csv",
    parse_dates=["date"],
)

# Set up the forecasting pipeline
pipe = TimeSeriesForecastingPipeline(
    model=model,
    id_columns=[],
    timestamp_column="date",
    target_columns=["HUFL"],
    max_context_length=model.config.context_length,
    context_length=512,
    prediction_length=64,
    impute_method=None,
    quantile_levels=[0.1, 0.5, 0.9],
    explode_forecasts=True,
    freq="1h",
)

# Create a forecast from the last 512 samples of the input dataframe
forecast = pipe(df.iloc[-512:])
보시다시피 미세 조정이나 작업별 모델 적합이 필요하지 않습니다. 파이프라인은 시계열의 최근 이력만 입력으로 받아 요청된 분위수를 포함한 미래 예측을 생성합니다.
위 예제는 공개적으로 이용 가능한 데이터를 사용한 간단한 예입니다. 예제 입력 데이터를 수요, 센서 텔레메트리, CPU 사용률, 에너지 소비량, 거래량, 트래픽, 가격 또는 정기적으로 샘플링된 다른 시계열을 포함한 자체 데이터로 바꿀 수 있습니다.
자체 데이터로 사용해 보세요: Hugging Face Hub에서 PatchTST-FM-r2 열기
노트북에서 스트리밍 시계열까지
이번 출시는 IBM Granite Time Series 모델을 중심으로 한 더 광범위한 노력과 연결됩니다. 기존 모델 포트폴리오에 새 모델을 추가합니다
데이터가 정적 DataFrame이 아니라 지속적으로 유입되는 애플리케이션을 위해 IBM과 Confluent는 최근 Confluent Cloud의 Early Access 프로그램을 통해 여러 Granite Time Series 모델을 제공하기 시작했습니다. 초기 포트폴리오에는 PatchTST-FM-r1, FlowState-r1.1, TTM-r3 및 TSPulse가 포함됩니다.
이 통합을 통해 Confluent Cloud의 Apache Flink를 사용하여 파운데이션 모델 추론을 스트리밍 애플리케이션에 직접 적용할 수 있습니다. 팀이 별도의 ML 환경을 설정하고 데이터를 이동할 필요 없이, 실시간 스트림에서 예측 및 이상 탐지 결과를 생성할 수 있습니다.
oMLX의 제작자이자 유지 관리자인 Jun Kim이 MLX 커뮤니티를 지원하기 위해 Hugging Face에 합류합니다
이 글은 Hugging Face 블로그의 Jun Kim, oMLX creator and maintainer, joins Hugging Face to...

Grabette: 로봇-조작 데이터를 기록하기 위한 오픈 시스템.
*함께 공유 데이터셋을 구축합니다.*
이 글은 Hugging Face 블로그의 Grabette: an open system to record robot-manipulation data를 한국어로 번역한...
보안 사고 공개 — 2026년 7월
이 글은 Hugging Face 블로그의 Security incident disclosure — July 2026를 한국어로 번역한 글입니다.

Thinking Machines의 Inkling에 오신 것을 환영합니다
이 글은 Hugging Face 블로그의 Welcome Inkling by Thinking Machines를 한국어로 번역한 글입니다.
Real World VoiceEQ 소개: 음성 AI의 사람다운 품질 측정
이 글은 Hugging Face 블로그의 Introducing Real World VoiceEQ: Measuring the human quality of voice...

파이토치의 프로파일링(3부): 어텐션이 전부다
이 글은 Hugging Face 블로그의 Profiling in PyTorch (Part 3): Attention is all you profile를...

네이티브-스피드 vLLM transformers 모델링 백엔드
이 글은 Hugging Face 블로그의 Native-speed vLLM transformers modeling backend를 한국어로 번역한 글입니다.

LeRobot v0.6.0: 상상하고, 평가하고, 개선하기
이 글은 Hugging Face 블로그의 LeRobot v0.6.0: Imagine, Evaluate, Improve를 한국어로 번역한 글입니다.

Hugging Face와 Cerebras가 Gemma 4를 실시간 음성 AI로 선보입니다
이 글은 Hugging Face 블로그의 Hugging Face and Cerebras bring Gemma 4 to real-time voice...

Hugging Face 모델 페이지에서 Every Eval Ever 결과 보기
이 글은 Hugging Face 블로그의 Featuring Every Eval Ever Results on Hugging Face Model Pages를...

HF Jobs에서 vLLM 서버를 한 명령으로 실행하기
이 글은 Hugging Face 블로그의 Run a vLLM Server on HF Jobs in One Command를...

FFASR Leaderboard 소개: 현실 세계에서의 ASR 벤치마크
이 글은 Hugging Face 블로그의 Introducing the FFASR Leaderboard: Benchmarking ASR in the Real World를...

매주 AI, 오픈 도구, 그리고 휴먼 인 더 루프가 포함된 huggingface_hub 배포
이 글은 Hugging Face 블로그의 Shipping huggingface_hub every week with AI, open tools, and a...

Transformers.js에서 제안된 Cross-Origin Storage API 실험하기
이 글은 Hugging Face 블로그의 Experimenting with the proposed Cross-Origin Storage API in Transformers.js를 한국어로...

Beyond LoRA: 가장 인기 있는 미세조정 기법을 이길 수 있을까?
이 글은 Hugging Face 블로그의 Beyond LoRA: Can you beat the most popular fine-tuning technique?를...

충분히 에이전트적인가요? 자체 도구로 오픈 모델 벤치마킹하기
이 글은 Hugging Face 블로그의 Is it agentic enough? Benchmarking open models on your own...

에이전트 기반 리소스 탐색: 에이전트에게 도구·스킬·다른 에이전트 검색을 맡기다
이 글은 Hugging Face 블로그의 Agentic Resource Discovery: Let agents search를 한국어로 번역한 글입니다.

GitHub CI를 Hugging Face Jobs로 마이그레이션
이 글은 Hugging Face 블로그의 Migrating Your GitHub CI to Hugging Face Jobs를 한국어로 번역한...

오픈 소스 커뮤니티가 에이전틱 RL을 위한 OpenEnv에 힘을 싣다
이 글은 Hugging Face 블로그의 The Open Source Community is backing OpenEnv for Agentic RL를...

PyTorch에서의 프로파일링(Part 1): torch.profiler에 대한 초보자 가이드
이 글은 Hugging Face 블로그의 Profiling in PyTorch (Part 1): A Beginner’s Guide to torch.profiler를...

Reachy Mini를 로컬에서 완전히 실행하기
이 글은 Hugging Face 블로그의 Reachy Mini goes fully local를 한국어로 번역한 글입니다.

OlmoEarth v1.1: 더 효율적인 지구관측 모델 제품군
이 글은 Hugging Face 블로그의 OlmoEarth v1.1: A more efficient family of models를 한국어로 번역한...

PaddleOCR 3.5: Transformers 백엔드를 활용한 OCR 및 문서 파싱 작업 실행
이 글은 Hugging Face 블로그의 PaddleOCR 3.5: Running OCR and Document Parsing Tasks with a...

Hugging Face Transformers 한글화 - 초벌 번역기 사용법
Hugging Face Transformers 문서를 한글로 번역하는 초벌 번역기 사용 방법을 안내하는 가이드입니다. 😊